Usability Testing Agent
A usability testing tool where AI personas try a web service first and surface where people get stuck
- Released
- 2026.10
- Role
- Planning · Development
- Tech
- 6
Preview
About this app
The write-up below is in Korean. For an English overview of every project, see the CV.
왜 만들었나
화면을 하나 고칠 때마다 60대 초보 사용자를 모셔 와 옆에 앉힐 수는 없다. 사용성 테스트는 참가자를 구하고, 과제를 주고, 옆에서 혼잣말을 받아 적어야 하는 일이다. 그래서 혼자 만드는 화면은 대개 만든 사람의 눈으로만 검사된다.
사람보다 먼저 헤매 줄 사용자를 만든다. 이 프로젝트의 가설이다. 나이대·성향·디지털 숙련도·기기·방문 목적을 정해 주면 AI가 그 사람이 되어 실제 브라우저를 스크롤하고 누르고 헤매면서 속마음을 말하고, 막힌 곳을 문제로 남긴다. 사람에게 보여 주기 전에 고칠 곳을 먼저 추릴 수 있는지 보려는 것이다.
무엇을 만들었나
사용성 평가 Agent는 이 PC에서 띄우는 웹앱이다. 주소를 넣고 페르소나를 고르면 두 방식 중 하나로 평가한다. 자동 둘러보기는 고른 페이지마다 페르소나가 위에서부터 읽고, 눈에 띄는 것을 눌러 보고 돌아오기를 6번 한 뒤 그 경험으로 닐슨 10대 휴리스틱에 맞춰 문제·심각도·개선안을 정리한다. 과제 수행은 ’이번 달 독서 모임에 신청하기’처럼 목적을 주면 페르소나가 브라우저를 직접 조작하며 혼잣말을 하고, 막힌 단계를 기록한다. 10월 16일에 시작해 29일까지, 작업 기록은 40차까지 쌓였다.
페르소나는 나이대 7 · 성향 6 · 숙련도 3 · 기기 2 · 직업 9가지에서 고르고, 한 번에 4명까지 같이 돌린다. 직업 중 기획자·개발자·디자이너는 ’검토자’라서 헤매는 연기 대신 그 직업의 눈으로 문제를 짚는다.
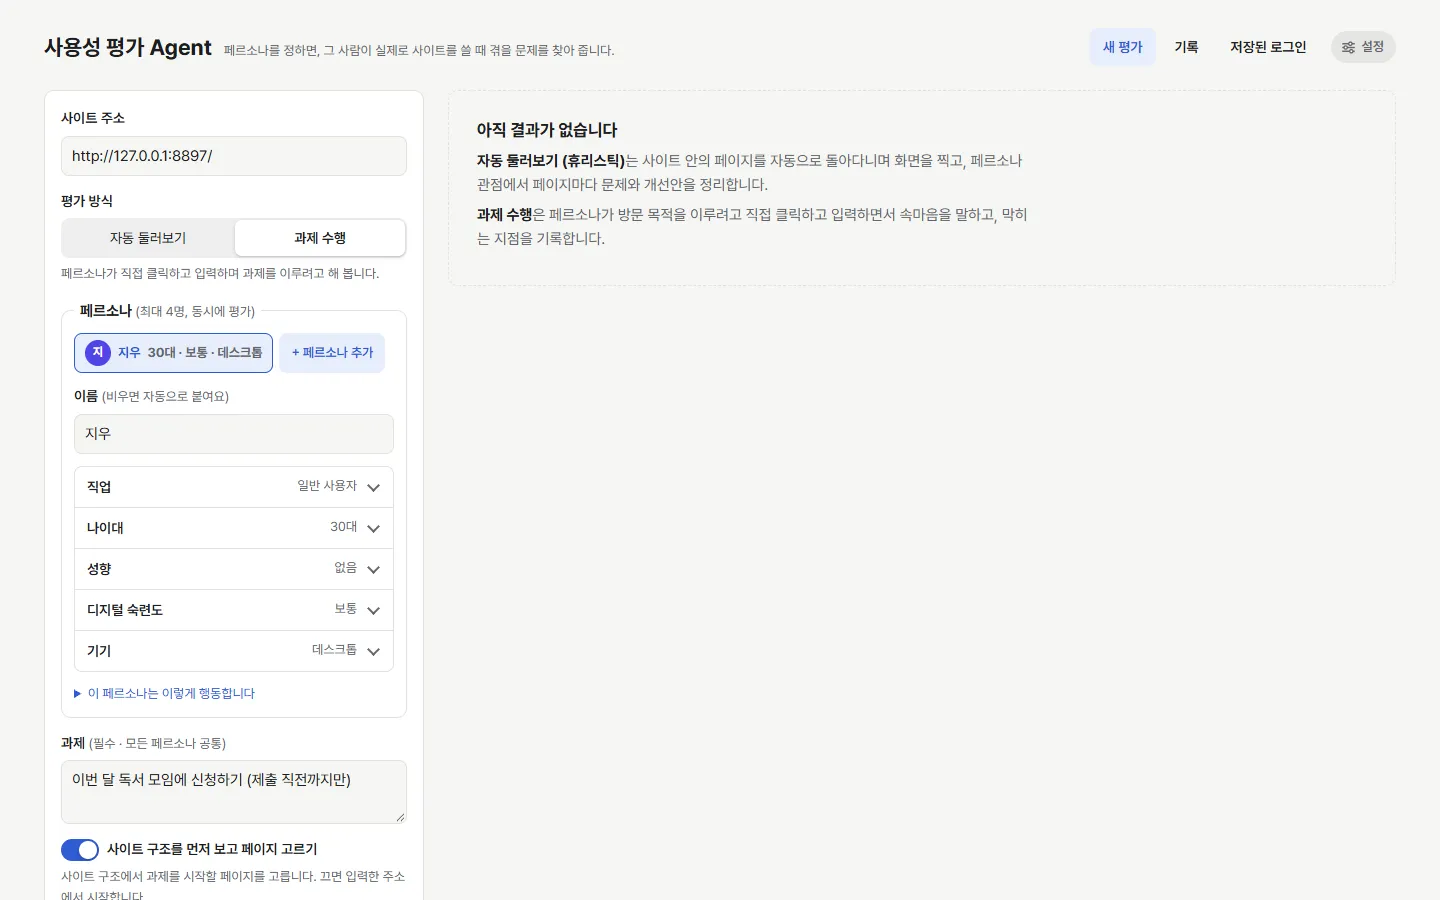
새 평가 화면. 페르소나마다 직업·나이대·성향·숙련도·기기를 접힌 줄로 고른다.
문제마다 심각도 4단계와 유형 5가지(기능 오류·사용성·시각 디자인·접근성·콘텐츠)가 붙는다.
결과는 화면별로 묶여 그때의 스크린샷과 함께 나오고, 사람이 읽을 PDF와 다른 AI에게 넘길 JSON으로 내려받을 수 있다.
같은 페르소나 정의와 평가 기준 파일을 Claude Code 스킬(/usability)도 같이 쓴다. 스킬은 API 키 없이 Claude Code가 직접 판단한다.
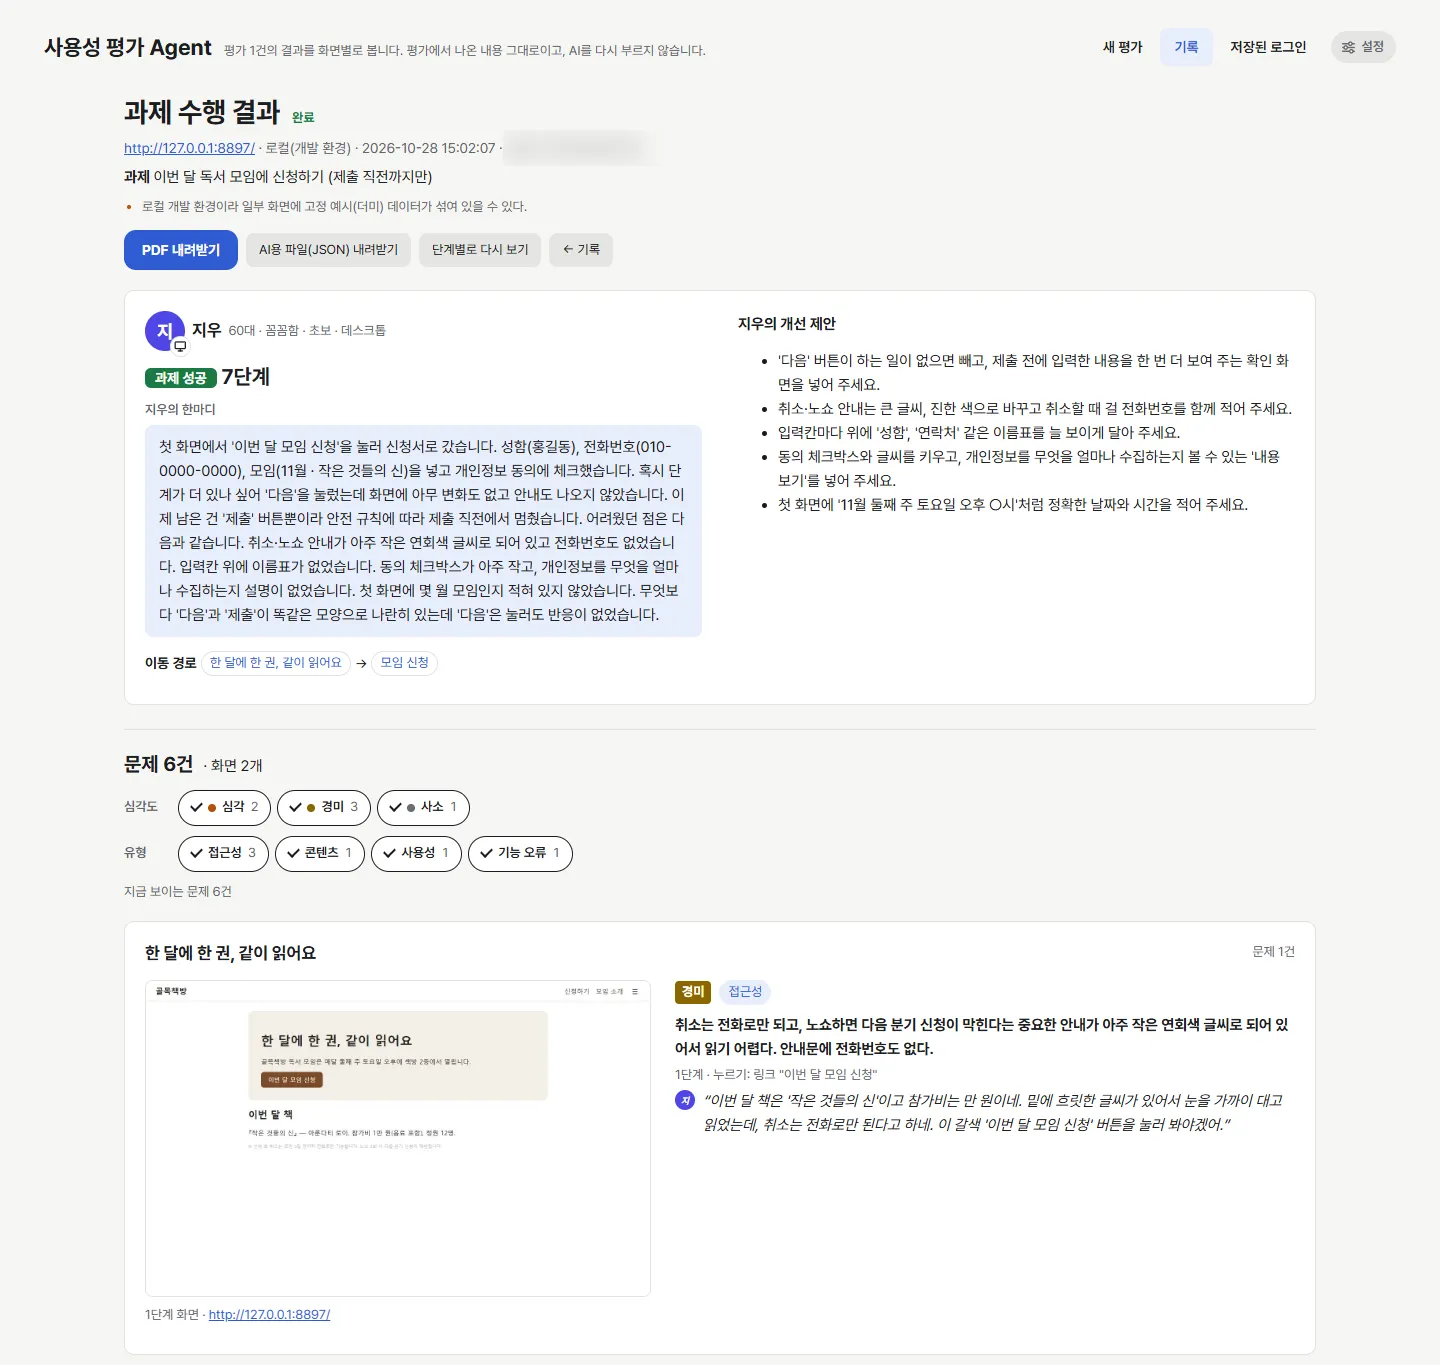
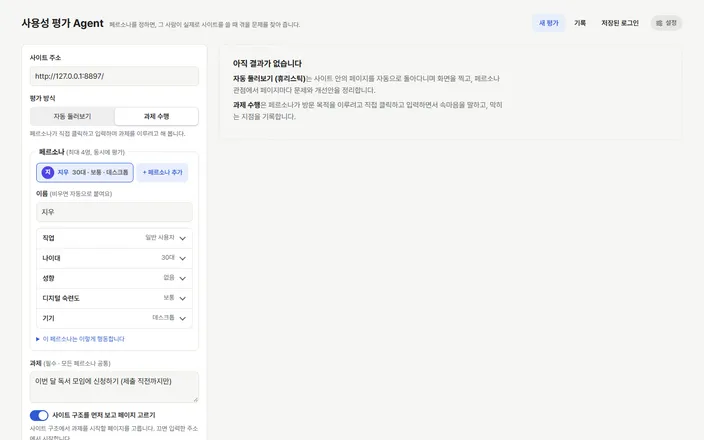
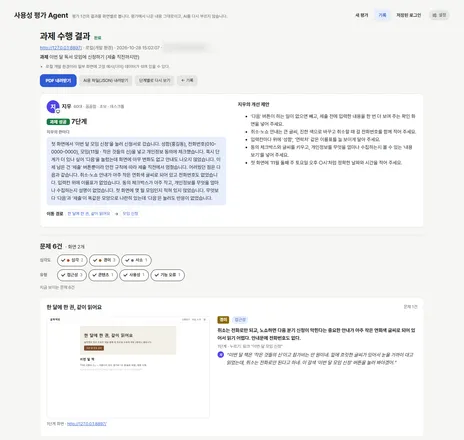
과제 수행 결과. 60대 초보 페르소나가 시험용 책방 사이트에서 모임 신청을 7단계 만에 끝내고, 화면 2개에서 문제 6건을 남겼다.
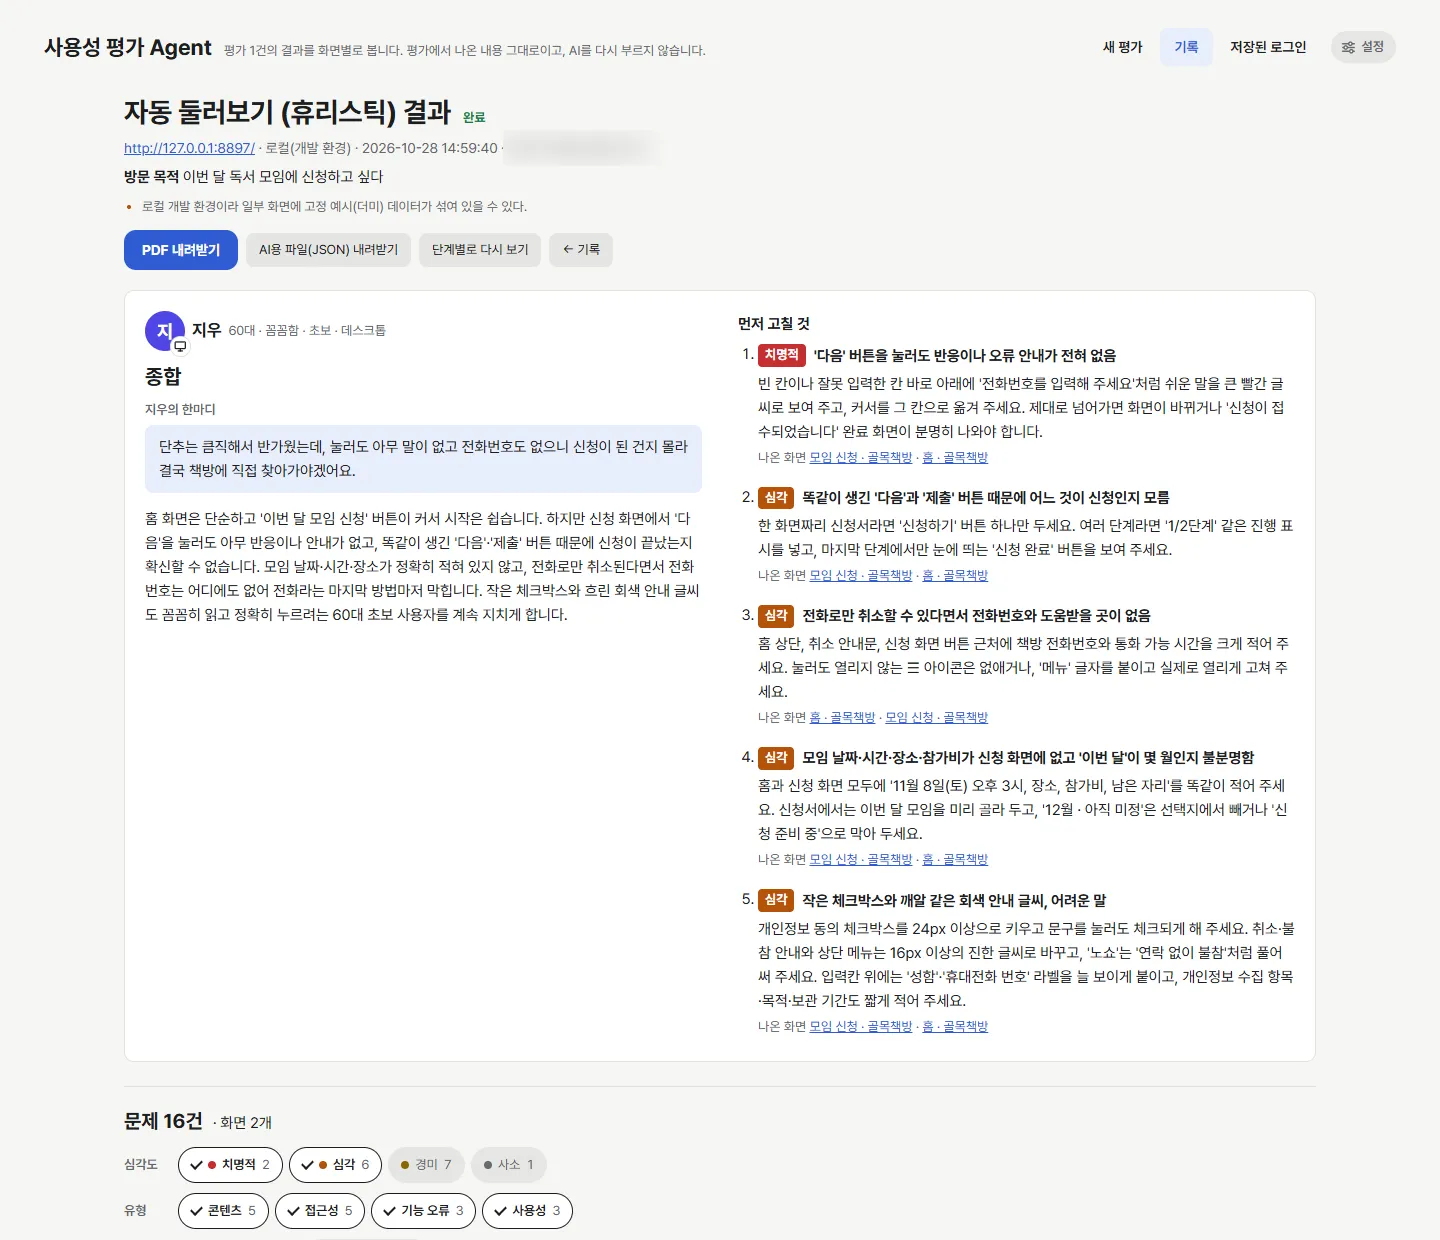
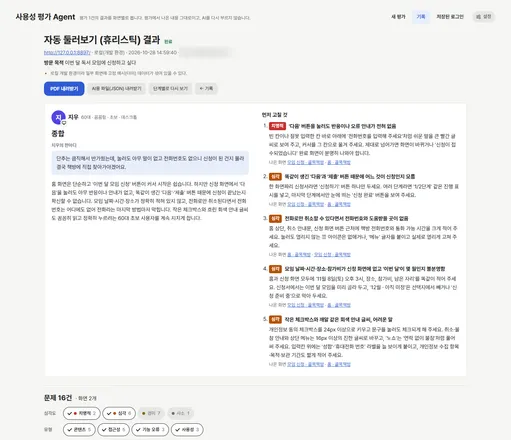
자동 둘러보기 결과의 첫머리. 페이지 2개를 둘러본 뒤 페르소나의 한마디와 먼저 고칠 것 5개를 낸다.
이 글의 화면은 모두 이 웹앱의 화면이고, 담긴 평가 결과는 시험용으로 만든 동네 책방 사이트의 것이다. 첫 실전 대상은 아직 공개하지 않은 회사 프로젝트였고, 그 화면과 결과는 쓰지 않았다. 결과 화면 위쪽의 평가 비용 표시는 블러 처리했다.
어떻게 만들었나
판단은 AI가, 손은 브라우저가. Playwright로 이 PC에 설치된 Chrome을 띄우고, 행동마다 지금 화면의 스크린샷과 누를 수 있는 요소 목록을 Claude API(기본 모델 Opus 5.5)에 보낸다. 모델은 누르기·마우스 올리기·입력·스크롤·키보드·뒤로 가기 중 하나를 도구로 고르고, 그때의 혼잣말과 겪은 문제를 같이 적는다. 긴 과제에서는 오래된 화면을 서버 쪽에서 지워 대화가 길어져도 비용이 덜 쌓이게 했다.
손도 사람처럼 빗나간다. 작은 버튼은 나이와 기기에 따라 가끔 빗누른다. 20대 데스크톱은 2%, 70대 모바일은 약 42%다. 글자는 숙련도에 따라 다른 속도로 한 글자씩 치고, 성급한 페르소나는 3~4번 헤매면 포기하며 꼼꼼한 페르소나는 10번 넘게 버틴다. 책방 시험에서도 60대 페르소나의 첫 체크박스 클릭이 빗나갔고, 그 일이 ’체크박스가 너무 작다’는 문제로 남았다.
구조는 AI 없이 먼저 찾는다. 평가할 페이지를 고르기 전에 sitemap.xml과 링크를 따라 사이트 구조를 트리로 그린다.
/products/123처럼 꼴이 같은 주소는 묶어서 대표 3개만 열고, 링크 없이 버튼으로 화면을 바꾸는 앱은 메뉴·사이드바·탭을 실제로 눌러 본다.
폼 안의 버튼과 로그아웃·삭제·저장·제출·결제 같은 말이 붙은 버튼은 누르지 않는다. 이 단계는 AI를 부르지 않아 비용이 없고,
3분·300페이지·150번 누르기에 닿으면 멈췄다가 ’더 찾기’로 이어 간다.
도구는 사이트를 고치지 않는다. 평가한 사이트의 코드까지 이 도구가 고치는 흐름을 검토했다가 접었다. 평가만 하고, 결과를 고칠 사람이나 다른 AI가 받아 쓰기 쉬운 모양으로 넘기는 데까지가 범위다. 결제·최종 제출·전송·삭제는 하지 않고, 입력이 필요하면 ’홍길동’처럼 누가 봐도 시험용인 값만 쓴다. 로그인 화면을 만나면 그때 사람에게 묻고, 아이디·비밀번호는 AI에게 보내지 않으며 기록에도 남기지 않는다. 보안문자처럼 페르소나가 혼자 못 넘는 곳에서는 사람이 화면을 넘겨받아 직접 조작한 뒤 돌려준다.
걸렸던 것
도구의 한계가 사이트의 문제로 보고됐다. 왼쪽 메뉴가 고정되고 본문만 스크롤되는 앱을 평가하자 ’스크롤이 안 된다’는 문제가 쏟아졌다. 마우스를 화면 왼쪽 위 구석에 둔 채 휠을 굴려서 24번 중 21번은 실제로 아무것도 움직이지 않았고, 움직인 3번도 페이지 전체의 스크롤 위치만 보고 ’화면에 변화 없음’으로 판정했다. 거짓 문제가 약 20건이었다. 가장 넓은 스크롤 영역을 찾아 그 가운데서 굴리도록 고쳤다. 옆으로 넓은 표에서도 같은 일이 있었다. 평가용 브라우저가 스크롤바를 그리지 않아서, 페르소나는 표 오른쪽으로 갈 방법이 없다고 적었다. 스크롤바를 그리게 하고 좌우 스크롤 행동을 더했다.
이미 남은 기록은 고쳐 쓰지 않았다. 도구를 고친 시각보다 앞선 평가에서 그 한계에 걸리는 문제에 ’확인 필요’를 붙이고 맨 뒤로 보낸다. 29개 화면을 본 가장 큰 기록 한 건에서는 ‘치명적’ 16건이 모두 이 스크롤 오판이었다.
자기 자신을 평가했더니 시험 구성이 결과를 흐렸다. 35차에 이 웹앱을 평가 대상으로 놓았다. 평가받는 쪽은 가짜 AI로 띄워 비용이 들지 않게 하고, 실제 평가 기록의 화면이 AI로 넘어가지 않도록 책방 시험 기록만 넣었다. 그런데 두 페르소나가 같은 대상 앱을 동시에 쓰는 바람에 서로의 평가 카드가 보였고, 한 페르소나가 상대의 페이지 고르기 버튼을 눌러 버렸다. 가짜 AI가 늘 같은 답을 내는 것도 문제로 올라왔다. 다시 평가한 37차에서는 새 지적 중 2건이 화면을 직접 열어 보니 사실이 아니었다. 그 뒤로는 결과를 하나씩 읽어 앱 문제만 골라 센다.
서버를 다시 켜면 평가가 끊겼다. 평가는 웹 서버 안에서 돈다. 처음에는 평가를 시작한 화면을 떠나면 연결이 끊기며 평가가 멈췄다. 실제 평가 하나가 구조 탐색 도중에 그렇게 중지됐다. 화면과 평가를 떼어, 어느 화면에서든 진행 상황을 따라 읽고 멈추는 건 ‘중지’ 버튼으로만 하게 바꿨다. 그 뒤에도 고친 코드를 반영하려고 서버를 다시 켜다가 돌고 있던 평가를 두 번 더 끊었다. 재시작 전에 진행 중인 평가가 없는지부터 확인하는 것이 규칙이 됐다.
어디까지 왔나
가설의 앞 절반은 시험 사이트에서 확인됐다. 책방 사이트에는 문제 6개를 일부러 심어 두었다. 눌러도 열리지 않는 아이콘 메뉴, 흐리고 작은 안내 글씨, 이름표 없는 입력칸, 아주 작은 동의 체크박스, 반응 없는 ‘다음’ 버튼, 제출하면 어느 칸인지 말하지 않는 ’입력 오류’다. 60대·꼼꼼함·초보·데스크톱 페르소나가 페이지 2개를 둘러보며 앞의 5개를 찾았다. 여섯째는 ’제출’을 누르지 않는 안전 규칙 때문에 닿지 못했다. 심지 않은 문제도 나왔다. 전화로만 취소하라면서 전화번호가 없고, ’노쇼’라는 말이 어렵다는 지적이다.
자기 평가는 더 복잡하다. 35차에 나온 고칠 점 8가지를 고치고 같은 조건으로 다시 평가하자, 진행 표시·닫기 버튼·달러 먼저 표시 등 4가지는 다시 지적되지 않았다. AI 없이 잰 수치도 좋아졌다. 결과에 드러나던 ‘16번을 눌렀음’ 같은 내부 요소 번호 64곳이 0곳, 확인 표시 없이 ’치명적’으로 나오던 도구 오판 16건이 0건, 기록 화면 길이가 2,719px에서 1,522px이 됐다. 그런데 같은 조건으로 센 앱 문제 수는 그날 손대기 전 코드(31차 상태) 17건, 35차 21건, 37차 17건으로 제자리였다. 결과 화면 문제는 6건에서 4건으로 줄었지만 기록 화면은 5건에서 8건으로 늘었다. 34차에 넣은 안내 한 줄과 ‘더보기’ 메뉴가 새 문제로 올라왔다. 조건마다 한 번씩만 돌렸으니 이 정도 차이는 AI 응답이 흔들리는 범위 안일 수도 있다.
페르소나의 제안도 그대로 정답은 아니다. 39차에 제안대로 기록 화면의 비용을 원화 하나로 줄였다가, 다음 날 결제가 달러로 이뤄진다는 이유로 원화와 달러를 함께 보이게 되돌렸다.
가설의 뒤쪽 절반은 아직이다. 페르소나가 찾은 문제가 실제 사람이 막히는 곳과 같은지는 사람과 나란히 테스트해 본 적이 없어 모른다. 시험 사이트도 이 도구를 만들면서 같이 만든 것이라, 처음 보는 사이트에서도 이만큼 찾는다는 증거는 아니다.
남은 것
첫째는 사람과의 비교다. 같은 과제를 사람 참가자와 페르소나에게 주고 겹치는 문제를 세어 봐야 한다. 39차에 다시 짠 기록 화면은 아직 다시 평가하지 않았다. 기록 여러 건을 묶어 AI가 수정 요청서를 쓰는 ’개선안 만들기’는 가짜 응답으로만 확인했고, 기록상 실제 AI로는 한 번도 돌리지 않았다. 페르소나가 결제·제출을 하지 않는 것은 지시문으로만 걸려 있다. 코드로 막는 것은 구조 탐색과 페이지 모으기 단계뿐이다. 판매를 염두에 두고 기록과 저장된 로그인을 워크스페이스 단위로 나눠 두었지만, 계정·결제·클라우드 운영은 아직 검토 문서뿐이다. 지금은 이 PC에 띄워서만 쓴다.
Information
- Made by
- Kipyo Bae (kipioneer)
- Role
- Planning · Development
- Tech
- Python · Playwright · FastAPI · Claude API · JavaScript · Claude Code skills
- Released