vacs — 수술 영상 아카이브 안에서 분석까지 도는 프로토타입
BABA RT 의 검토 신호와 추론 단계를 VACS.AI 의 화면 구조 안으로 옮겨, 영상 업로드부터 단계 인식·리포트·자연어 검색까지 한 앱에서 돌게 한 프로토타입. 두 번째 술식의 단계 모델은 아직 검증 데이터로만 확인한 상태다.
- 날짜
- 역할
- 기획 · 개발
- 기술
- Next.js · PyTorch · SQLite · Claude API · Cloudflare Tunnel
왜 만들었나
BABA RT 의 검토 우선순위 큐는 영상 아카이브와 따로 떨어진 대시보드 안에 있었다. 입력도 미리 만들어진 CSV 57건이라, 새 영상은 CSV 가 먼저 생겨야 분석에 들어올 수 있었다.
검토 신호는 영상을 찾고 보는 화면 안에 있어야 쓰인다고 봤다. 올린 자리에서 분석이 돌고 결과가 목록과 리포트에 바로 붙으면, “올리고 → 분석하고 → 검토하는” 흐름이 한 앱 안에서 닫힌다. vacs 는 이 가설을 확인하려고 만든 BABA RT 의 고도화 버전이다.
무엇을 만들었나
vacs 는 회사 제품인 수술 영상 아카이브 VACS.AI 의 화면 구조(Archive · Insight · Surgenie 세 탭)를 따라 다시 세운 Next.js 프로토타입으로, 회사 제품을 바탕으로 기획부터 구현까지 직접 한 개인 작업이다. 화면만 흉내 낸 목업이 아니라 영상을 올리면 이 PC 의 GPU 가 도구 검출과 수술 단계 인식을 돌리고, 결과가 목록·리포트·검색으로 이어진다.
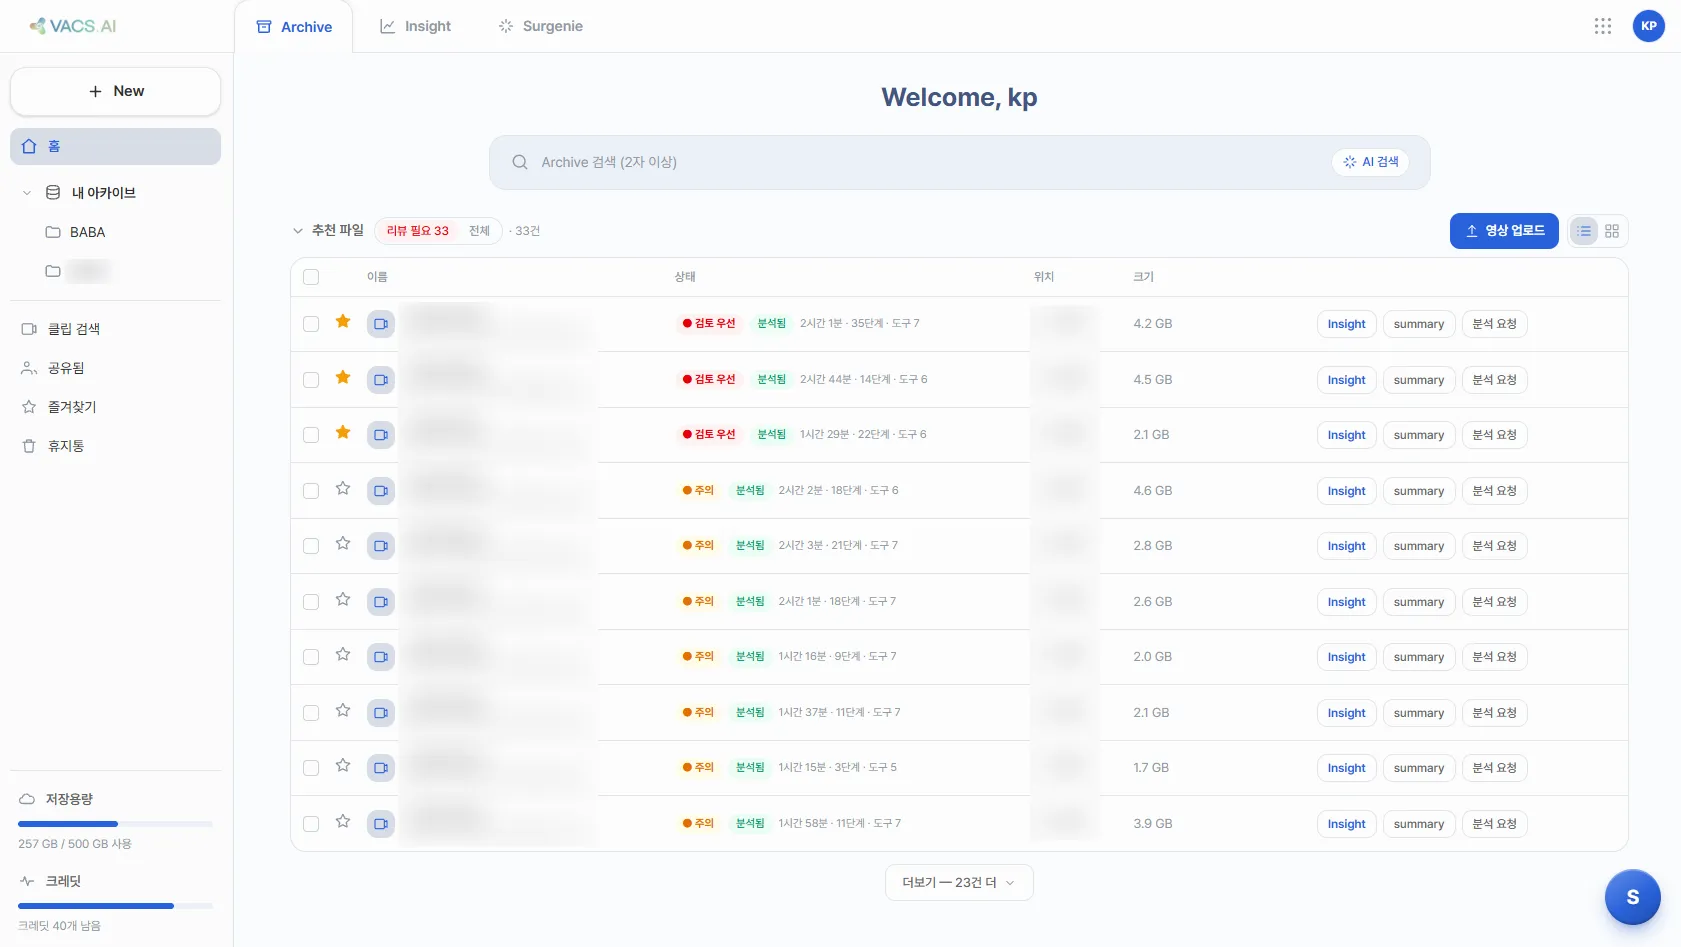
Archive 홈. 분석된 영상마다 검토 신호(검토 우선·주의)와 분석 요약이 붙고, ‘리뷰 필요’ 필터를 켜면 먼저 볼 영상만 남는다.
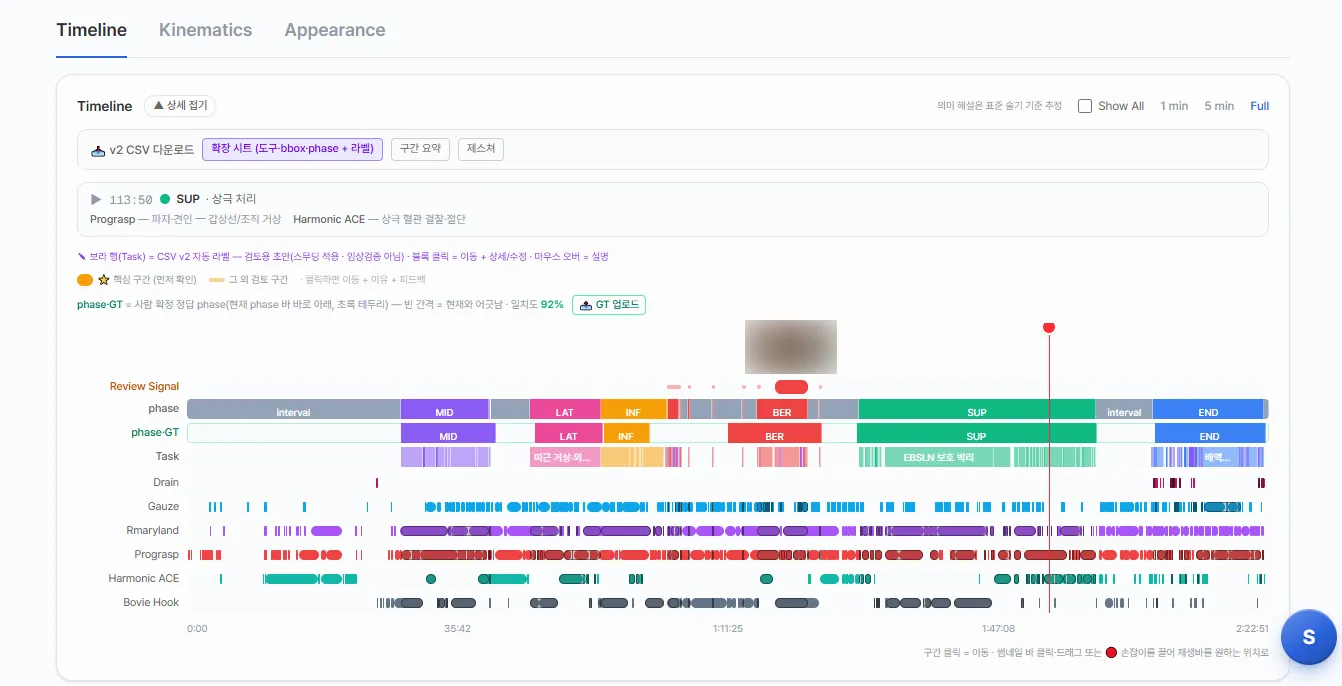
리포트의 Timeline. 모델이 예측한 단계(phase)와 사람이 확정한 정답(phase-GT)을 위아래로 놓고, 그 아래에 과업(Task)과 도구별 사용 구간을 같은 시간축으로 쌓았다. 맨 위 Review Signal 레인이 먼저 볼 구간이다.
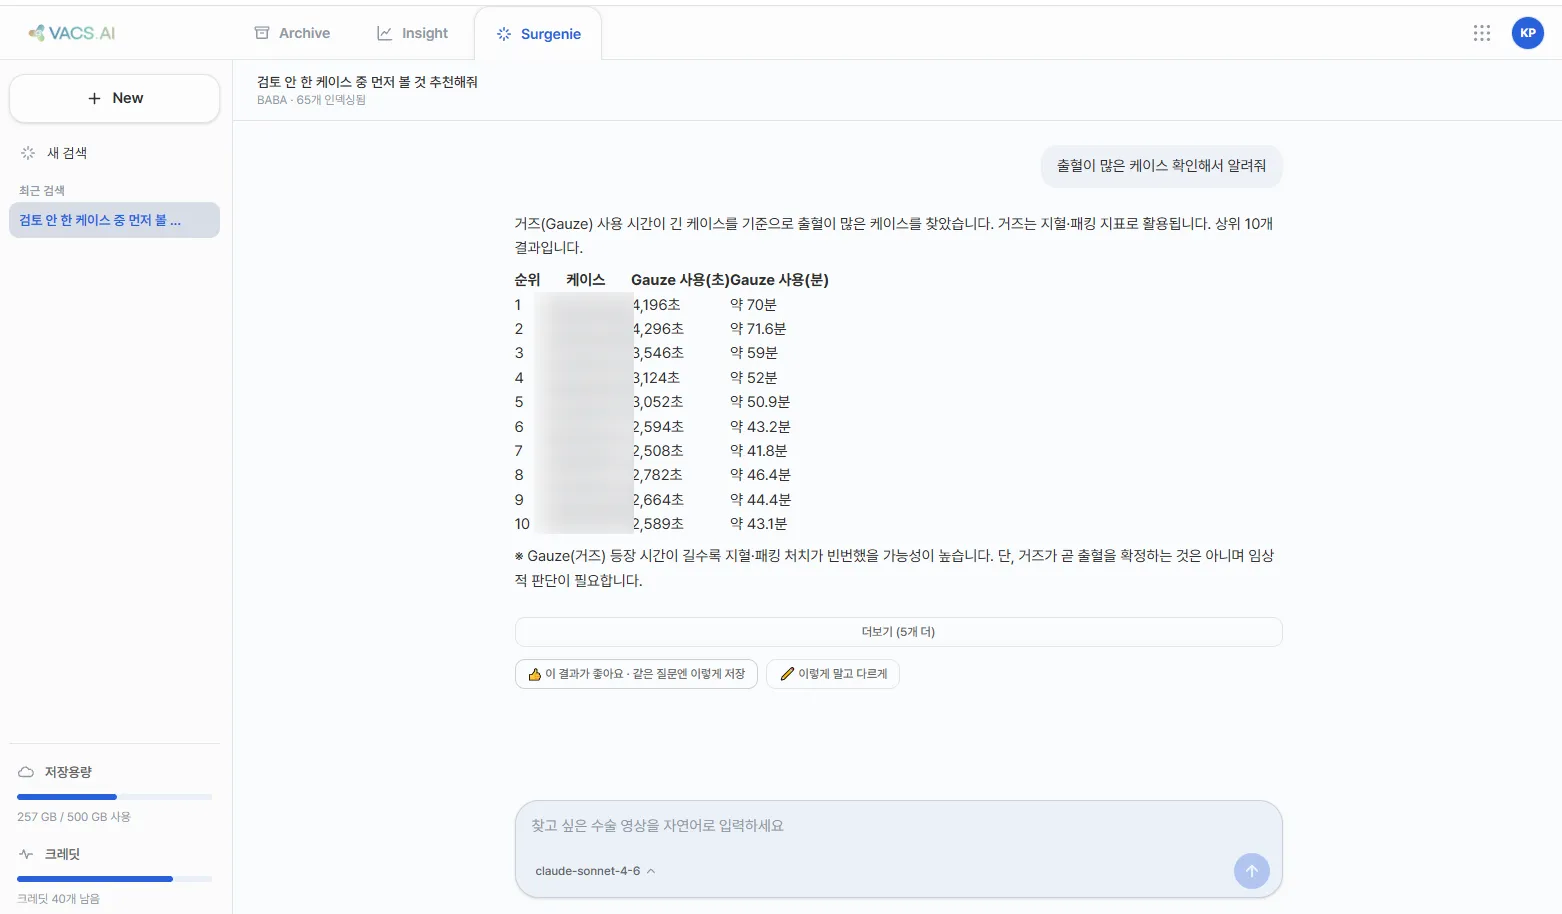
Surgenie 검색. 같은 BABA RT 계보의 Surgenie 에서 옮겨 온 것으로, 문장으로 물으면 LLM 이 검색 조건(JSON)과 설명을 만들고 필터와 정렬은 서버가 그 조건대로 결정론으로 실행한다. 이 답에는 “거즈가 곧 출혈을 확정하지는 않는다”는 단서도 달렸다.
리포트 화면은 영상 플레이어를 잘라 내고 썸네일을 블러 처리했다. 모든 화면의 케이스 식별자와 수술 연도도 가렸다. 화면 구성을 보여주는 것이 목적이므로 환자·케이스를 특정할 수 있는 정보는 남기지 않았다.
어떻게 만들었나
추론을 앱 안으로. BABA RT 는 이미 만들어진 CSV 를 읽었지만, vacs 에는 그 앞 단계를 직접 넣었다. BABA 추론 번들(YOLO 도구 검출 26종 → bi-LSTM 단계 인식 7단계)을 7월 1일 앱에 들여 업로드 → 분석 요청 → 진행률 → 결과 병합까지 이었다. 영상 파일은 옮기지 않고 디스크 위치만 인덱싱한다.
판정은 규칙, LLM 은 두 곳만. 검토 신호는 BABA RT 의 규칙을 그대로 쓴다 — 단계×도구 사용 시간 비율을 동료 57건 분포와 비교해 p87 이상이면 우선 검토, p75 이상이면 주의다. 앱이 LLM 을 부르는 곳은 검색, 그리고 수술기록 요약에 붙여 넣은 기록 텍스트를 정리하는 곳 두 군데뿐이고, 둘 다 텍스트만 보낸다.
원본은 그대로, 사람 수정은 오버레이로. 과업·제스처 자동 라벨은 LLM 없이 결정론 스크립트로 만들고, 사람의 교정·정답·리뷰는 원본 옆에 키 단위 오버레이로 저장한다. 오버레이를 지우면 원복이다. 내려받는 확장 CSV 는 원래 컬럼을 바이트 그대로 두고 라벨 컬럼만 고쳐, 다음 학습 라운드의 입력으로 다시 쓸 수 있다.
클라우드 대신 이 PC. SQLite·파이썬 프로세스·로컬 영상·GPU 에 기대는 구조라 서버리스 호스팅에는 올릴 수 없었다. 이 PC 를 서버로 두고 Cloudflare 터널로 열었고, 회원가입은 관리자가 승인하기 전까지 로그인되지 않게 했다.
걸렸던 것
검증 점수만 보던 모델이 실제 경로에서는 돌지 않았다. 두 번째 술식의 단계 모델을 처음에는 사람이 단 정답 주석의 23개 피처로 학습했다. 그런데 그 23개를 만들어 줄 검출기가 없어, 영상을 넣으면 분석이 첫 단계에서 멈췄다. 도구 검출기는 그대로 두고 단계 모델만 검출기가 실제로 내는 출력(도구 + bbox, 130차원)으로 다시 학습했다. 학습 입력과 추론 입력은 같은 곳에서 나와야 한다.
케이스를 반복한다고 드문 단계가 늘지 않는다. 가장 드문 단계인 추가 봉합(phase 13)의 재현율이 0.36 이라 그 단계가 든 케이스를 네 배로 늘려 학습했더니, 오히려 0.19 로 떨어졌다. 그 단계는 케이스 안에서도 짧은 구간이라 나머지 구간까지 네 배가 돼 그 케이스들에 과적합된 것이다. 체크포인트 선택 기준을 전체 정확도에서 단계별 평균 재현율(macro)로 바꾸자 0.81 이 됐다.
어디까지 왔나
가설은 절반만 확인됐다. BABA 영상은 업로드부터 분석·리포트·검색까지 한 앱 안에서 끝까지 돌지만, 그 덕에 검토가 실제로 늘어나는지는 아직 사용자로 확인하지 못했다.
두 번째 술식은 가진 케이스 전량으로 다시 학습하자, 데이터로는 안 풀린다고 봤던 interval(단계 사이 전환·대기) 재현율이 0.15 에서 0.47 로 올라 처음 판단이 틀렸음을 확인했다. 이어서 bi-LSTM 을 MS-TCN 으로 바꾸고 단계가 거의 순서대로 진행된다는 성질을 Viterbi 디코딩으로 넣어, 같은 검증 세트에서 정확도 0.632 → 0.735, macro 0.691 → 0.807 이 됐다. 하이퍼파라미터 7조합에서 macro 는 0.788~0.811 로 평평해 튜닝 여지는 거의 없고, 케이스별로는 예전 모델이 나은 경우도 있다.
남은 것
두 번째 술식의 숫자는 아직 검증 데이터 위의 숫자다. 검토 신호의 임계(p87 · p75)도 BABA RT 때처럼 전문가 확인 전의 가설이다. 계정은 여러 개여도 영상 저장소는 하나라, 업로드를 계정별로 나누는 일이 남았다. 단계 모델의 다음 레버는 도구 신호만이 아니라 프레임 자체를 입력으로 쓰는 것이다.