Surgenie — BABA RT 파이프라인을 영상 라이브러리 앱으로
BABA RT에서 검증한 검토 파이프라인을 채팅 검색과 케이스 화면을 갖춘 웹 앱으로 옮기고, 마지막 주에 수술기록 요약의 첫 시안을 붙였다. 개인 연구용 로컬 프로토타입이고, 임상 해석에 대한 의사 검증은 아직이다.
- 날짜
- 역할
- 기획 · 개발
- 기술
- Claude Code · Next.js · Claude API · SQLite
왜 만들었나
수술 영상은 외장하드와 PC 여기저기에 흩어져 있고, 한 건이 한두 시간이다. BABA RT로 “어느 케이스부터 볼지”는 골라 냈지만, 고른 뒤 그 영상 파일을 찾아 그 장면까지 가는 일은 여전히 사람 몫이었다.
아이디어는 수술 요약지 자동화에서 출발했다. 그런데 요약지에 무엇을 쓸 수 있는지는 영상에서 무엇을 읽어 낼 수 있느냐에 달려 있어서, 첫 버전은 그 앞 단계부터 만들었다. BABA RT에서 검증한 파이프라인을 영상 라이브러리 안으로 옮기면, 찾고 → 보고 → 기록하는 일이 한 흐름이 되고 요약지로 갈 재료도 함께 쌓인다고 봤다.
무엇을 만들었나
Surgenie의 첫 버전은 Next.js 웹 앱이다. 작업 폴더 이름은 SurGPT였다. 회사 프로젝트를 개인 연구용 프로토타입으로 진행했고, 영상과 기록은 연구자 PC 안에만 둔다.
채팅창에 “검토 안 한 케이스 중 우선순위 높은 것”처럼 평소 말투로 물으면, 조건에 맞는 영상 카드가 신호등과 추천 장면 시각을 달고 나온다. 카드를 누르면 두 시간짜리 영상이 그 장면부터 재생된다.
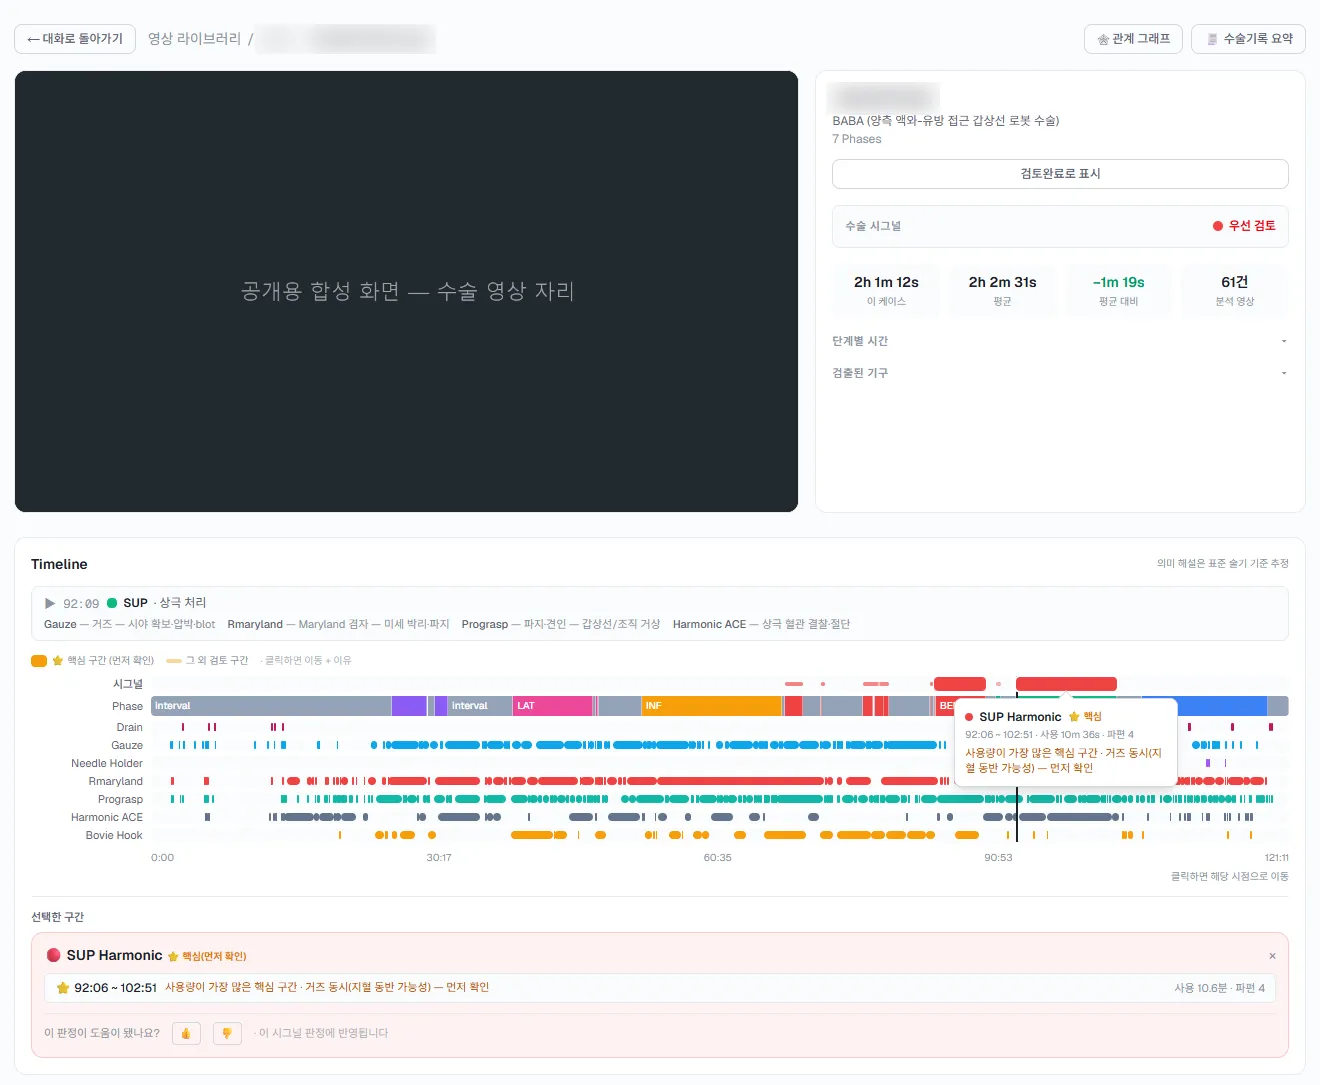
케이스 화면은 영상 타임라인 위에 시그널 구간 레인을 둔다. 핵심 구간(⭐)은 크게, 나머지는 옅게 그리고, 구간을 누르면 그 구간의 근거와 👍/👎가 아래에 열린다. BABA RT에 있던 외부 의학 자료 대조도 이 화면으로 들어왔고, 대조 결과 중 사람이 승인한 것만 지식베이스에 쌓인다.
케이스 화면. 타임라인 위 레인에서 ⭐ 핵심 구간을 누르면 그 구간의 근거와 👍/👎가 아래에 열린다.
수술기록 요약은 이 버전의 마지막 주에 붙인 첫 시안이다. 단계별 시간, 검출된 기구, 시그널처럼 영상 분석에서 셀 수 있는 칸은 코드가 채우고, 진단·병기·절제연·림프절처럼 영상이 답할 수 없는 칸은 🔎 표시로 비워 둔다. 빈칸은 EMR이나 집도의 구술 텍스트를 붙여 넣으면 LLM이 구조화해 채우고, 완성본은 Word와 PDF로 내려받는다.
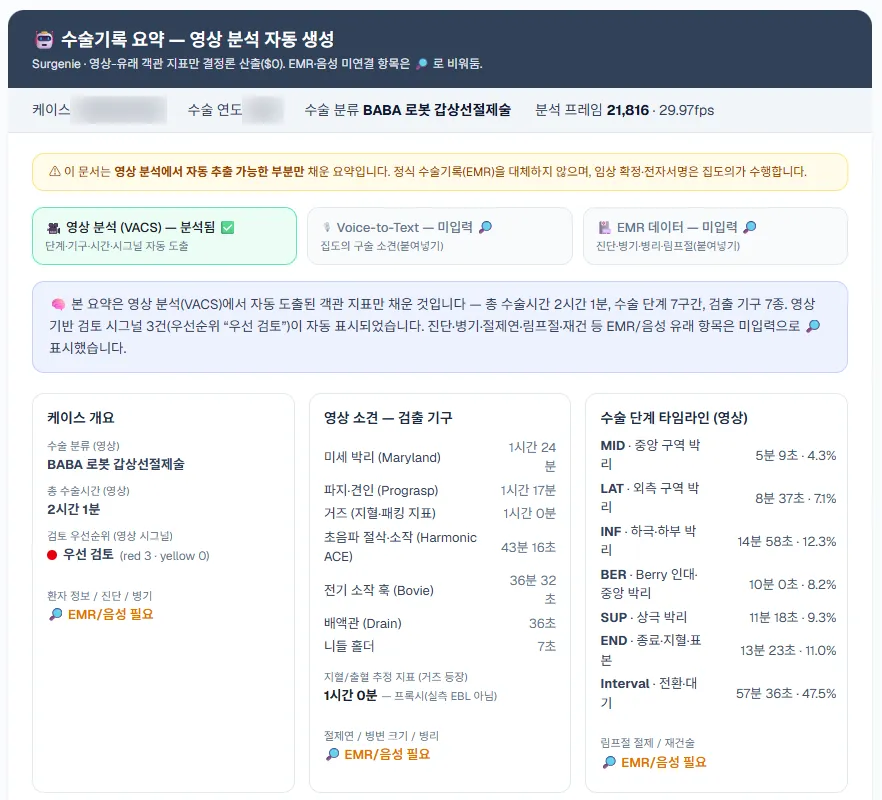
수술기록 요약 첫 시안. 영상에서 셀 수 있는 칸만 채우고, 나머지는 🔎로 비워 둔다.
영상 자리는 같은 길이의 합성 화면으로 바꿔 찍어 수술 프레임이 들어가지 않았다. 케이스 식별자와 수술 연도는 블러 처리했다. 화면 구성을 보여주는 것이 목적이므로 환자·케이스를 특정할 수 있는 정보는 남기지 않았다.
어떻게 만들었나
계산은 코드, 해석은 AI. LLM은 자연어 질문을 검색 조건(JSON)으로 바꾸는 데까지만 하고, 필터·정렬·개수는 코드가 계산한다. 같은 질문이면 언제나 같은 결과가 나온다. 채팅이 가리키는 추천 장면과 케이스 화면의 ⭐ 구간도 같은 계산에서 나온다.
판정의 근거를 숫자로 드러낸다. 시그널은 기구 사용 시간을 전체 케이스 분포와 비교한 통계적 깃발이지, 위험하다는 의학적 판정이 아니다. 화면에 그렇게 적고, 실측값·기준선·전체 중 순위를 함께 보여준다.
검토한 만큼 할 일이 줄어든다. 본 구간과 검토 완료 표시가 저장되고, 검토를 마친 케이스는 “검토 안 한 케이스” 검색에서 저절로 빠진다.
요약지는 비식별을 두 겹으로. EMR 텍스트를 LLM에 보낼 때 프롬프트로 환자 식별자 출력을 막고, 그 결과에서 등록번호 같은 숫자 식별자를 코드로 한 번 더 지운다. 이름은 규칙으로 잡기 어려워 LLM에 맡긴다는 한계도 코드에 적어 뒀다.
걸렸던 것
화면은 저장됐다고 말했지만 저장되지 않았다. 리포트에 남긴 메모는 사라졌고, 검토 표시는 새로고침하면 풀렸다. 몇몇 버튼은 처리됐다는 안내만 띄우고 실제로는 아무것도 하지 않았다. 저장이 실제로 되게 고치고, 아직 없는 기능은 “준비 중”이라고 답하게 바꿨다. 검토 도구에서 가짜 성공은 검토를 안 한 것보다 나쁘다.
정밀해 보이는 숫자가 오해를 만들었다. “왜 RED인가”의 마지막 단계가 “상위 N%이니 위반 가능성”이라는 순환 논리였다. “실측 97.7%, RED 임계 94.0% — 임계보다 3.7%p 높음”으로 바꾸고, “상위 N%“는 “동료 52건 중 2번째로 높음”으로 고쳤다. 외부 대조를 맡은 LLM이 사용 시간 비율을 빈도로 읽은 일도 있어서, 입력에 “신경과의 거리나 빈도가 아니라 사용 시간 비율”이라고 못 박았다. 마지막 주의 수술기록 요약에서도 “상위 %“가 오독돼, 표기를 “N건 중 R위”로 통일했다.
어디까지 왔나
가설의 앞 절반은 확인됐다. 찾기 → 장면부터 보기 → 검토 기록이 한 앱 안에서 이어졌고, 6월 11일 기준으로 영상 61건, 그 프레임 분석 61건, 케이스 검토 리포트 18건이 그 안에 있었다.
추천 장면이 맞는지는 실제 화면으로 시험했다. 추천이 “기구를 쓰는 중”이라 한 시각 18곳과 “볼 것 없음”이라 한 시각 18곳을 캡처해 정답을 가린 채 채점했다. 앞쪽은 18장 중 15장(83%)이 맞았고(흐림 2, 가려짐 1), 뒤쪽은 18장 모두 맞았다. 6월 말에는 로봇 콘솔 화면에 찍히는 기구 표시를 정답처럼 써서 시그널 10개를 대조했고, 기구와 단계가 10건 모두 일치했다.
뒤 절반인 요약지는 이제 시작이다. EMR은 연동이 아니라 텍스트를 붙여 넣는 방식이고, 위 두 대조도 기구·단계 같은 객관 사실만 확인했다. 콘솔 대조는 AI 판독이었고, 임상 해석에 대한 의사 검증은 남아 있다.
남은 것
요약지가 제품의 중심이 되려면 화면 한 장이 아니라 흐름이 필요하다. 이 버전은 그 앞의 검색·검토가 대부분이었다. 일반 사용자가 “값이 이상하다”고 제안하는 경로와, 케이스 화면으로 역할을 넘긴 정적 리포트 생성기를 완전히 걷을지도 결정을 기다린다.