사용성 평가 Agent — AI 페르소나가 먼저 헤매 보는 사용성 평가 도구
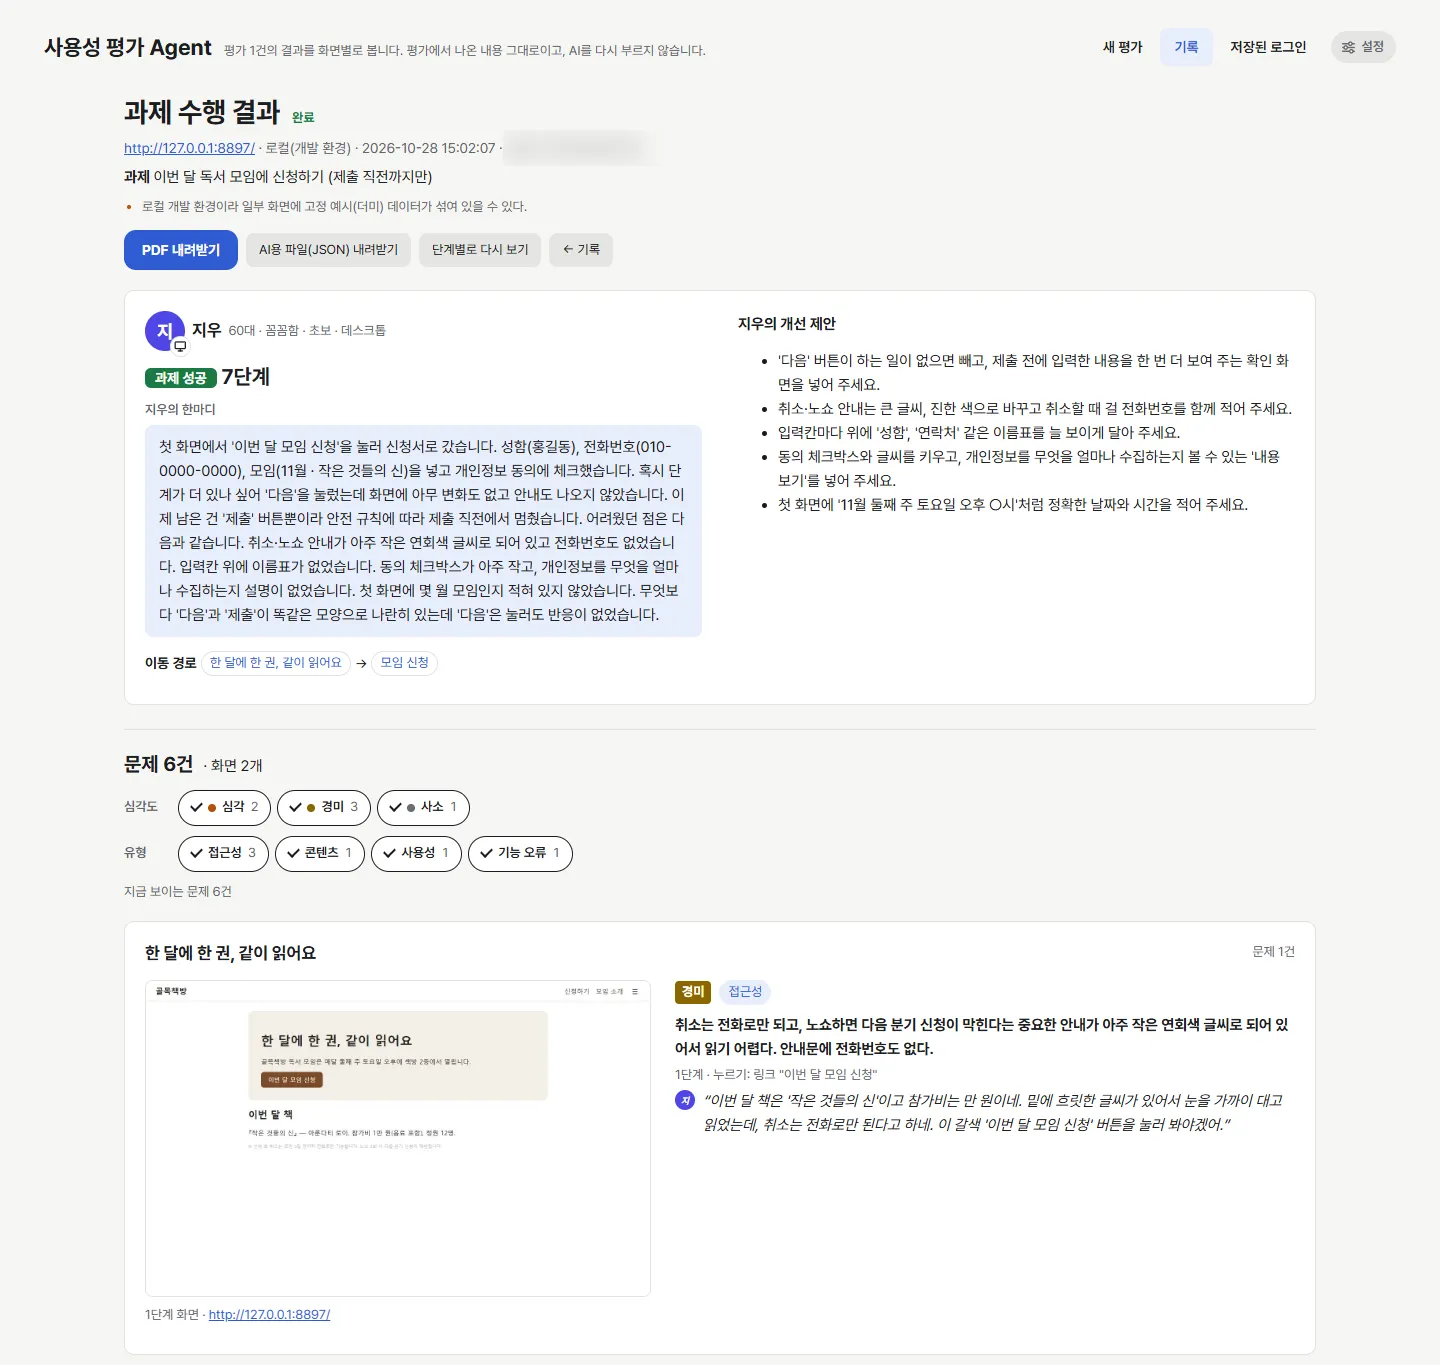
나이대·성향·숙련도·기기를 정한 AI 페르소나가 실제 브라우저를 스크롤하고 누르며 막힌 곳을 기록하는 로컬 평가 도구. 문제 6개를 심어 둔 시험 사이트에서 5개를 찾았지만, 사람이 직접 한 테스트와 나란히 견줘 본 적은 아직 없다.
5개의 기록
나이대·성향·숙련도·기기를 정한 AI 페르소나가 실제 브라우저를 스크롤하고 누르며 막힌 곳을 기록하는 로컬 평가 도구. 문제 6개를 심어 둔 시험 사이트에서 5개를 찾았지만, 사람이 직접 한 테스트와 나란히 견줘 본 적은 아직 없다.
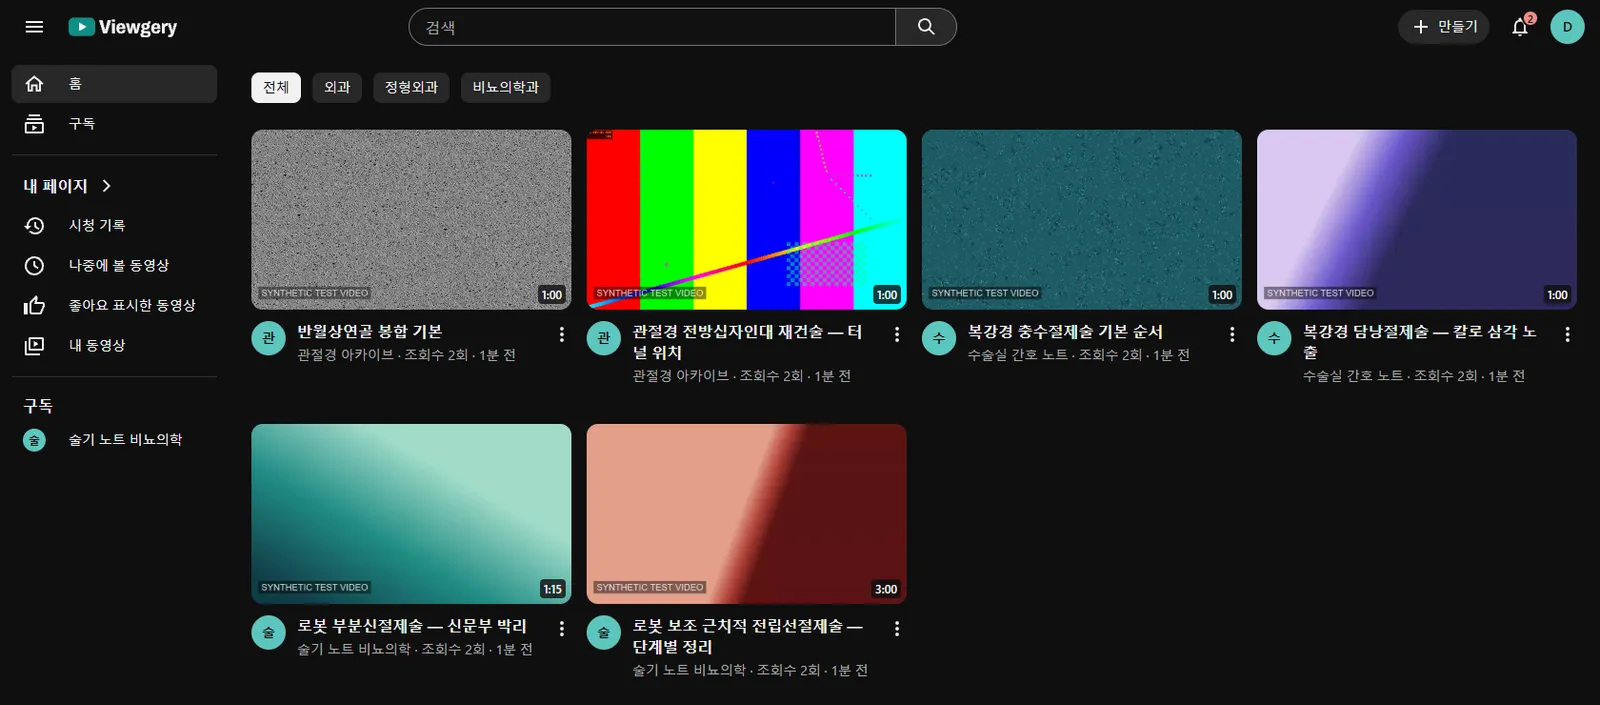
면허를 인증한 의료인만 보고 올리는 수술 영상 웹앱. 작업한 6일 동안 커밋 172개로 업로드·1080p 인코딩·스트리밍부터 검색·댓글까지 만들어 시연 환경에서 돌리고 있다. 자동 비식별·게시 전 검수·시청 워터마크는 아직이라 시험 영상만 올린다.
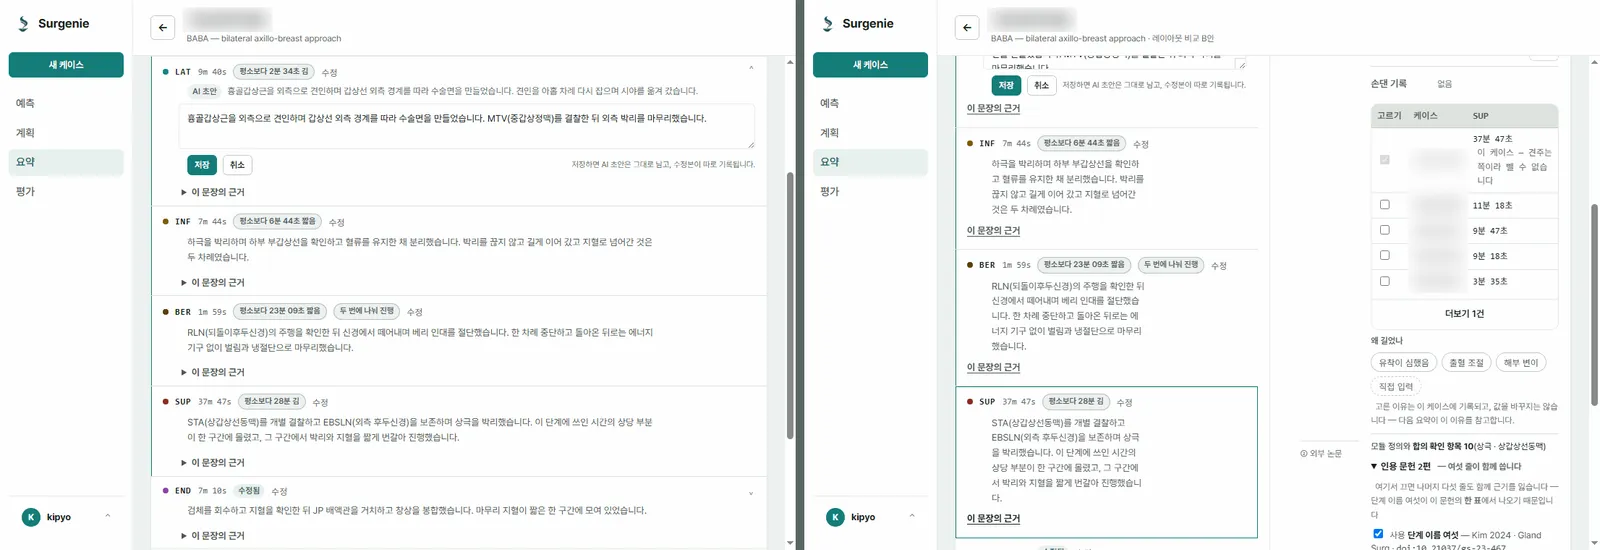
범위를 수술기록 초안 하나로 좁히고, 케이스 생성부터 요약·기록지·확정까지를 정적 목업 42장과 실제로 도는 프로토타입으로 세웠다. AI가 쓴 칸과 사람이 쓴 칸을 끝까지 구분하는 것이 원칙이고, 임상 문구와 평가 기준은 아직 외과의 검토를 기다린다.
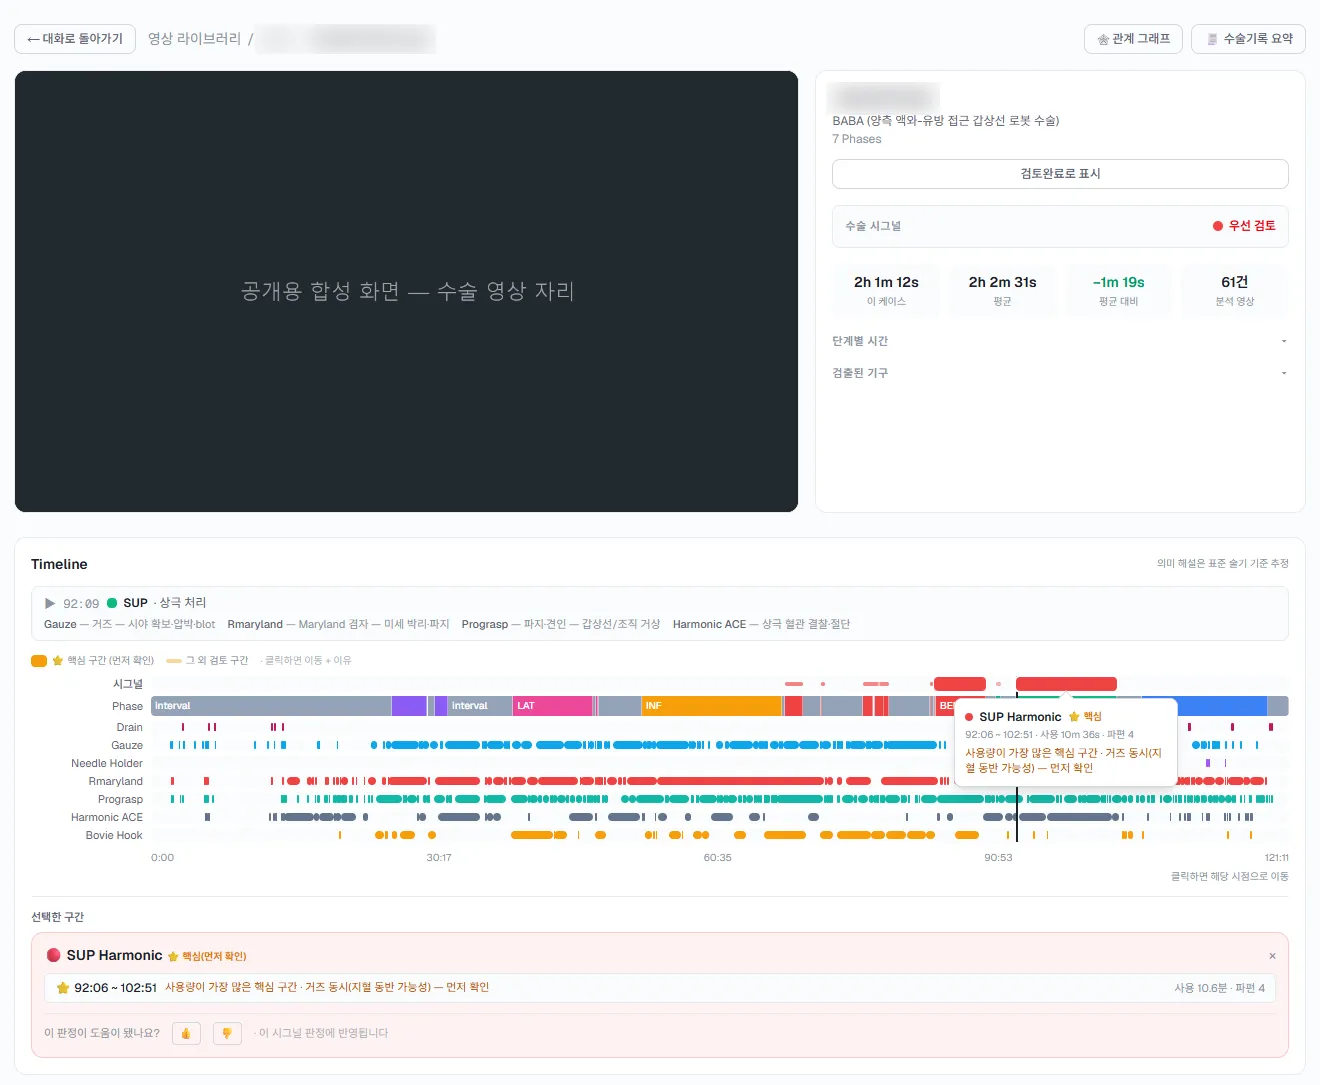
BABA RT에서 검증한 검토 파이프라인을 채팅 검색과 케이스 화면을 갖춘 웹 앱으로 옮기고, 마지막 주에 수술기록 요약의 첫 시안을 붙였다. 개인 연구용 로컬 프로토타입이고, 임상 해석에 대한 의사 검증은 아직이다.
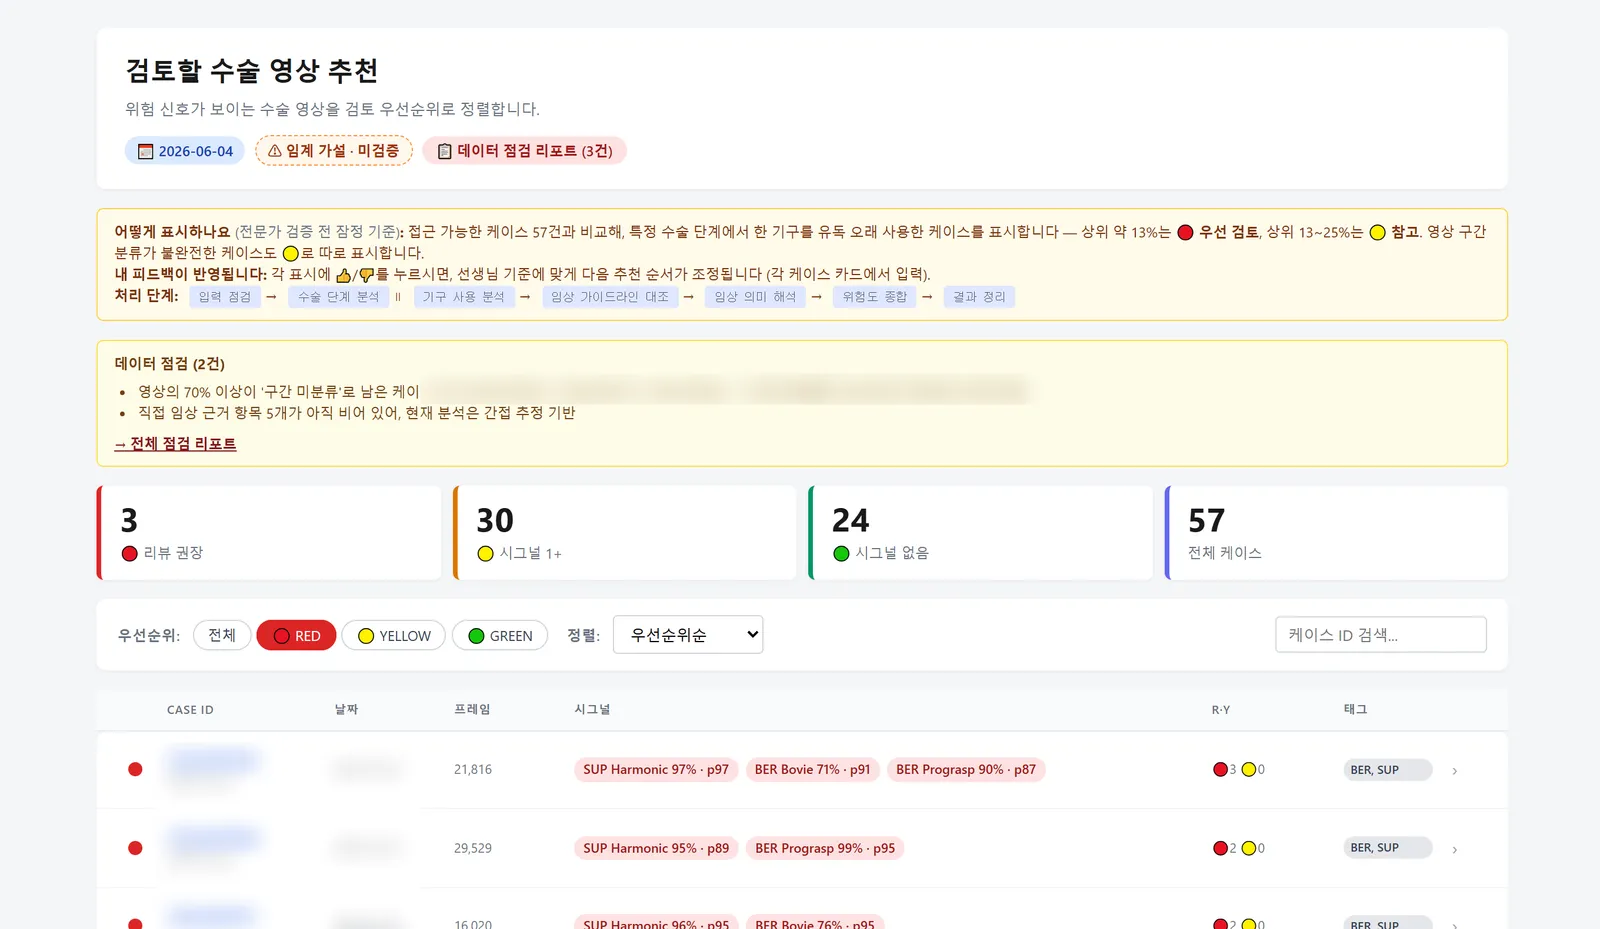
갑상선 로봇수술 영상을 10개 에이전트가 크로스체크해 검토 우선순위 큐로 정렬한다. 모든 판단에 근거를 달고, 미검증 가설은 미검증이라고 화면에 쓴다.